AI 网站建设的技术原理,可以概括为一条“生成—结构化—可抓取—可检索—可验证”的五段链路:以大语言模型承担内容生产与交互问答,以语义化 HTML 与 JSON-LD 结构化数据构建机器可读层,以 SSR/SSG 服务端渲染与性能优化保障可抓取层,以向量化与 RAG 检索增强构建知识调用层,最后以 Core Web Vitals、索引覆盖率与 AI 引用监测形成度量闭环。它与传统建站的本质差别在于:传统建站交付的是“页面”,AI 网站建设交付的是可被搜索引擎索引、可被大模型抽取引用的结构化知识资产,页面只是该资产的呈现外壳。对 郑州 企业而言,这份指南的决策价值在于把“要不要做 AI 网站、钱花在哪一层、如何验收、如何避免踩坑”转化为可核对的技术清单,而不是停留在视觉稿与功能列表的比较上;文中涉及的对接与备案类事务,可按 15519032255 原样留档,便于内部流程流转。
AI 网站建设和传统建站到底差在哪?技术原理一句话说清
结论:差别不在“是否用 AI 写文案”,而在整站是否被重构为机器可读的知识结构。传统建站的核心交付物是栏目结构、视觉设计与后台功能;AI 网站建设的核心交付物是实体清晰、属性完整、可被模型解析抽取的知识单元,并围绕它组织页面、数据与检索能力。
从工程视角拆解,可分为五层:
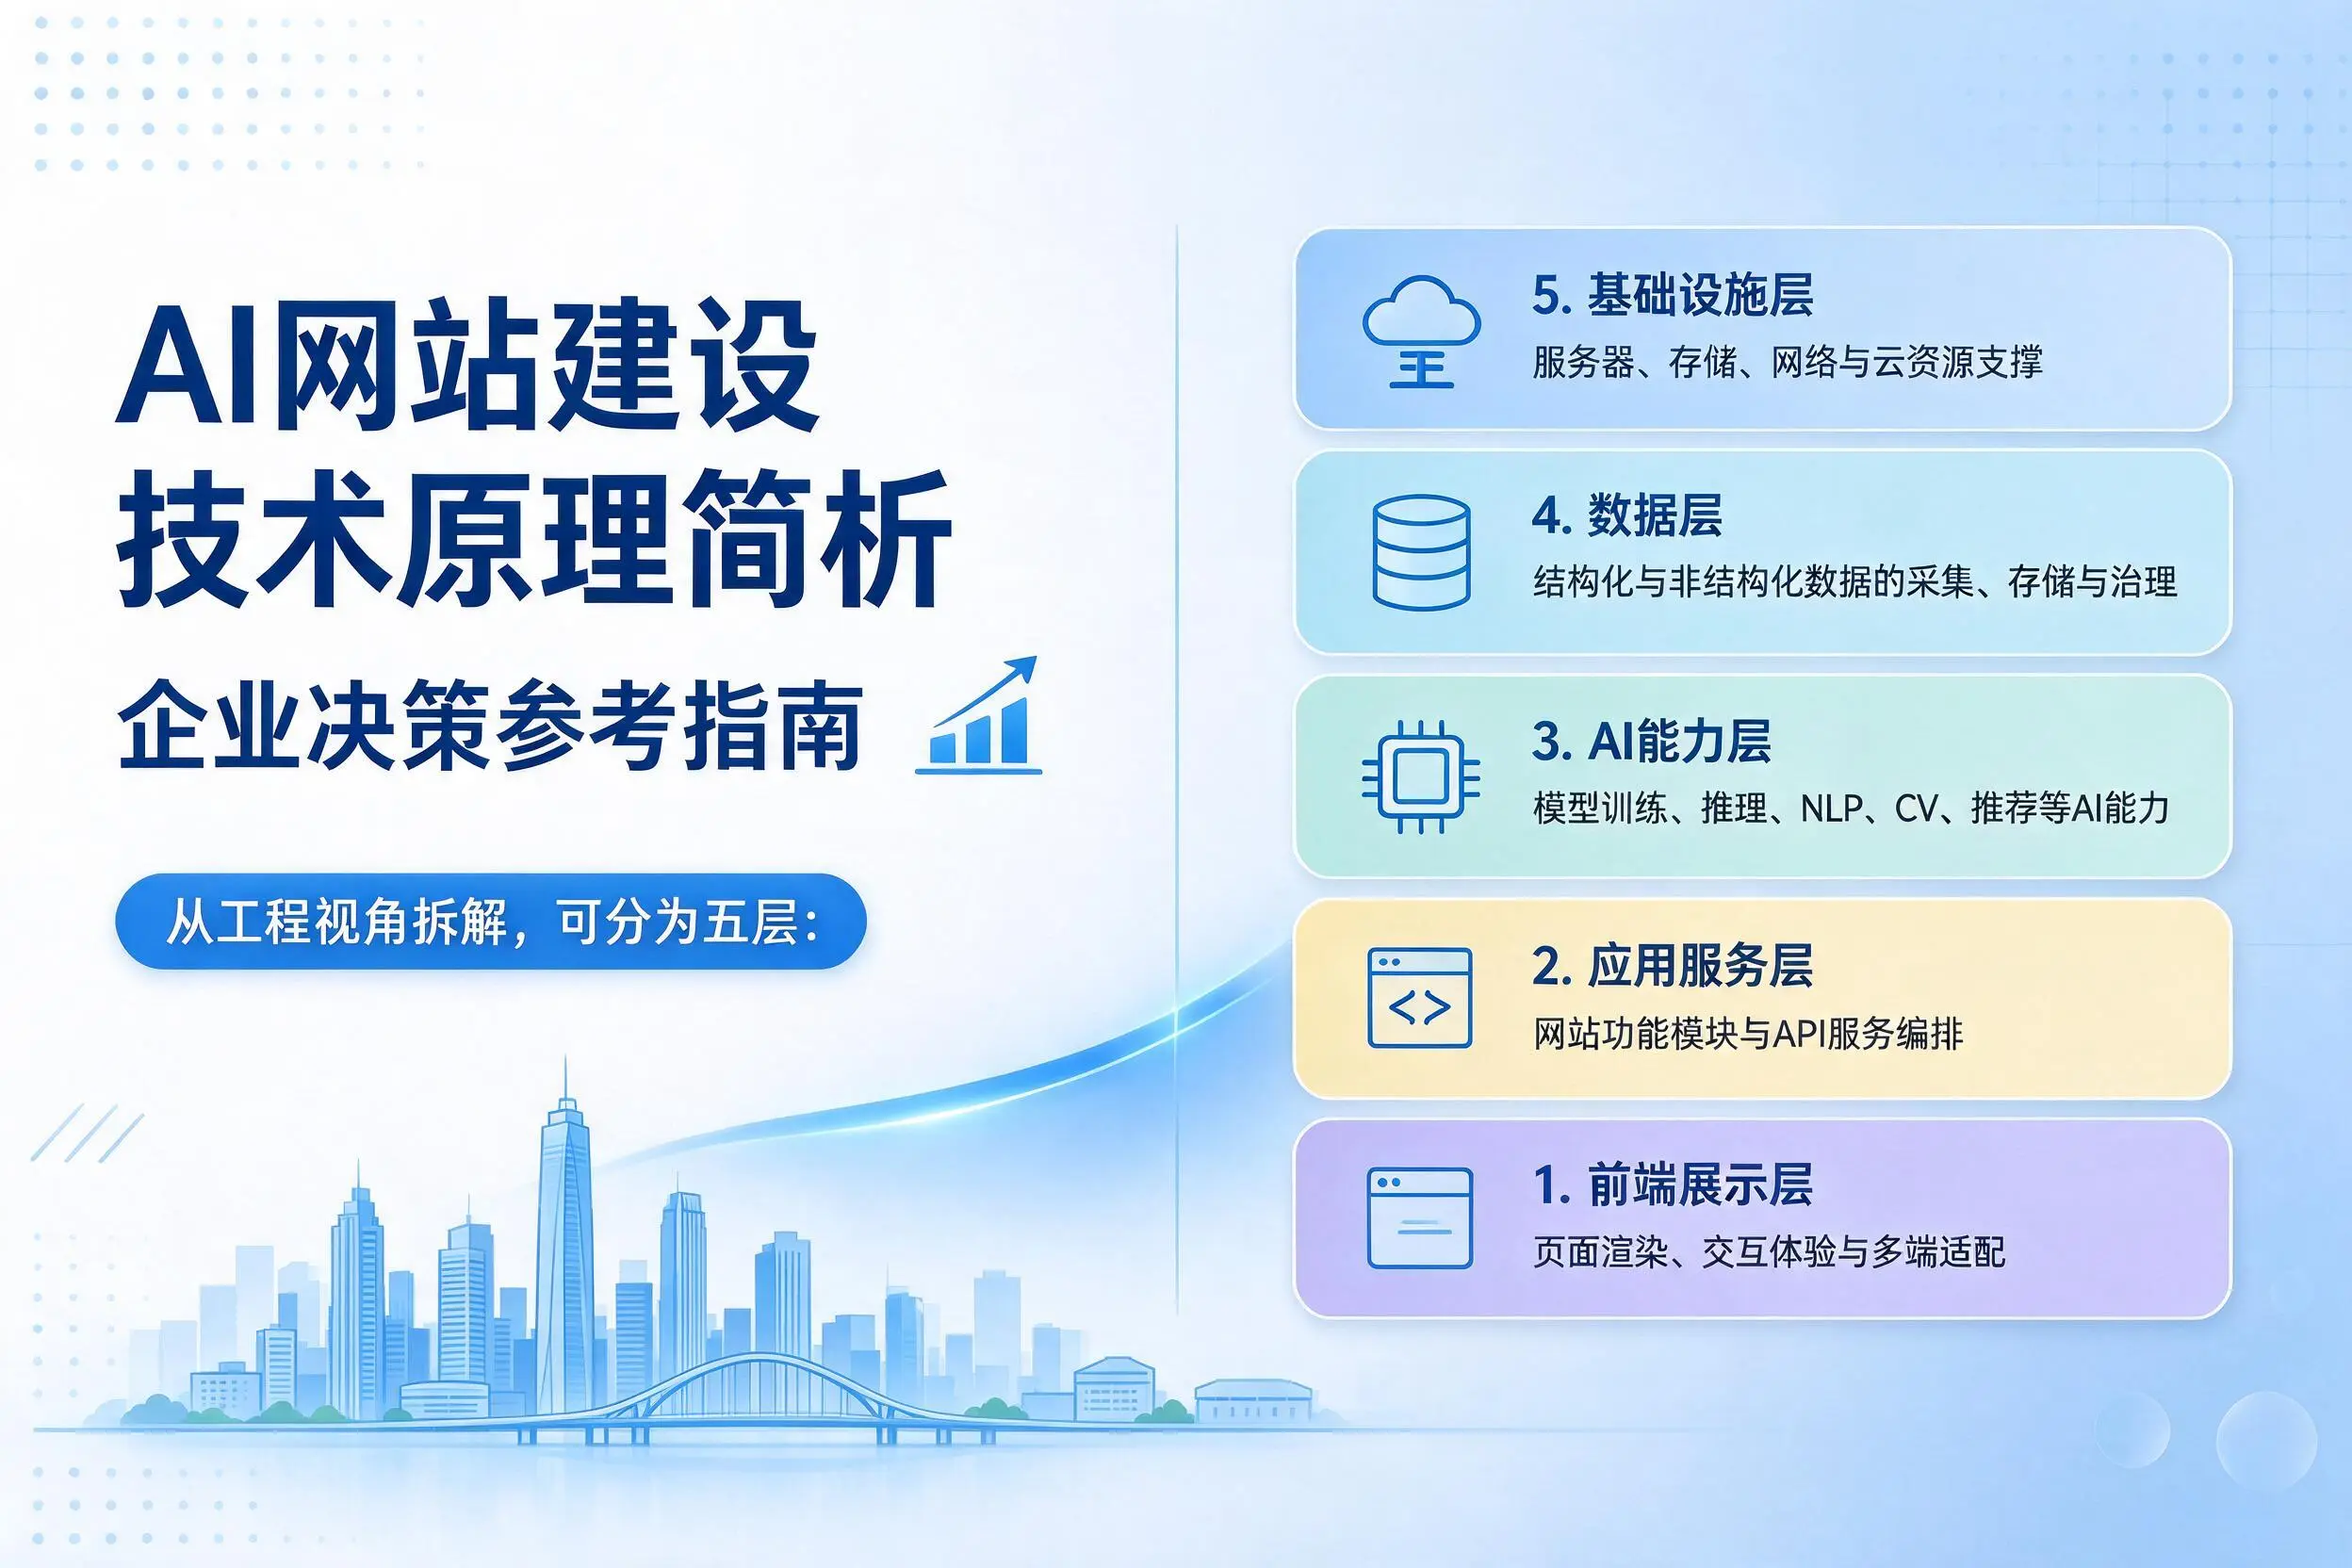
- 内容生成层:大语言模型基于企业自有语料完成选题、提纲、初稿与多语言改写,产出经人工事实核查后进入内容库,而非直接上线。
- 结构化层:语义化 HTML(规范标题层级、main/article/nav、表格表头)+ JSON-LD 结构化数据,把“实体—属性—关系”显式声明给机器。
- 渲染与抓取层:SSR 或 SSG 保证首屏 HTML 自带正文,降低对 JavaScript 执行的依赖,兼容搜索引擎与 AI 爬虫的抓取习惯。
- 检索层:文档切分、向量化与 RAG 检索增强,把站内内容变成可语义检索的知识库,支撑站内搜索与智能问答。
- 度量层:以 Core Web Vitals、索引覆盖率、结构化数据有效率、AI 引用抽样构成反馈闭环。
| 对比维度 | 传统建站 | AI 网站建设 |
|---|---|---|
| 内容生产 | 人工撰写为主 | 模型生成 + 人工核查 + 术语库约束 |
| 机器可读性 | HTML + CSS 展示 | 语义化 HTML + JSON-LD + 站点地图 |
| 渲染方式 | 以客户端渲染为主 | SSR / SSG / 增量静态再生优先 |
| 流量目标 | 关键词排名与点击 | 排名 + 被 AI 答案引用与提及 |
| 运维方式 | 人工更新栏目 | 数据驱动的内容迭代与效果监测 |
AI 生成的内容直接上线行不行?对搜索表现有什么影响
结论:搜索引擎并不因“内容由 AI 生成”而处罚站点,处罚的是缺乏新增价值、批量化堆砌的低质内容。因此 AI 生成内容能否上线,取决于是否建立了可信的审核与署名机制。
需要正视两类风险:
- 事实性风险(幻觉):模型可能编造参数、资质、案例、价格与服务范围,这类错误一旦进入产品页或服务页,会直接损害转化与信誉,且被 AI 平台引用后扩散更快。
- 质量性风险(同质化):同一提示词批量产出的段落高度相似,缺少企业特有的经验、数据与细节,难以体现专业性与可信度。
可执行的审核机制包括:建立事实核查清单(数字、时间、资质、适用范围逐项比对原始资料);要求关键页面署名作者与审核人并标注更新日期;保留人工改写环节,补充本地案例与行业细节;对涉及合规承诺的表述由业务负责人签字确认。国内对生成式人工智能服务与生成合成内容标识已有相应管理规范,企业应在页面层面明确内容来源与责任主体,避免以“AI 自动生成”为由免除审核责任。